Anatomia di un furto: noi e Navier-Stokes
In data 8 settembre, sul blog dell’azienda di intelligenza artificiale OpenAI è comparso un post il quale sostiene che un modello di IA generativa non disponibile al pubblico – ed evidentemente più potente del loro ultimo modello: GPT-6 Astra – abbia risolto le equazioni di Navier-Stokes, uno dei sette problemi del millennio.
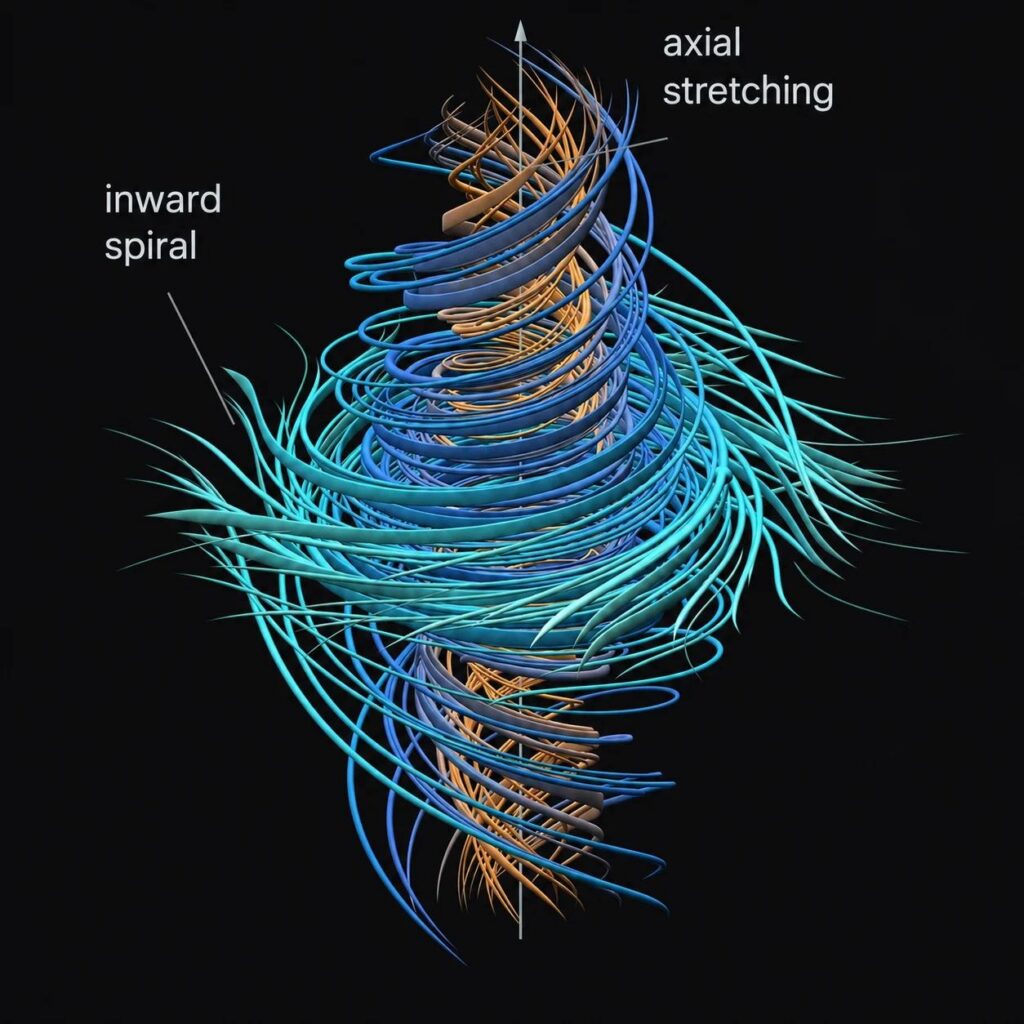
L’equazione di Navier-Stokes è l’equazione fondamentale della dinamica dei fluidi classica e descrive un fluido (come l’aria o l’acqua) in termini newtoniani, ossia applicando il secondo principio della dinamica (F=ma) a un fluido incomprimibile, visto, approssimando, come oggetto continuo e non come insieme di atomi. Si tratta di un sistema di equazioni differenziali le cui soluzioni sono oggetti continui in uno spazio a infinite dimensioni e servono per calcolare la variazione di velocità di un fluido a partire dal gradiente di pressione, dalla viscosità e dalle forze esterne (gravità o forze applicate). Sono concetti che nascono tra 700 e 800, ma nonostante l’apparente semplicità concettuale sono equazioni di cui non si riesce a scrivere una soluzione analitica per la versione generale, per cui è necessario utilizzare ulteriori approssimazioni per semplificare dei termini (approssimazioni che per la maggioranza dei casi sono più che sufficienti, specialmente in campo ingegneristico). Solo nel XX secolo è stato dimostrato che delle soluzioni generali esistono. La domanda irrisolta rimane: se io fisso le mie condizioni iniziali può accadere che la mia soluzione a un certo punto sviluppi una singolarità? Ossia è possibile che la soluzione mi dia una velocità infinita in un tempo finito (cioè ad energia finita)?
Il problema del millennio riguarda dunque lo status di regolarità di questa equazione, cioè la validità di questo modello classico e delle approssimazioni sopra citate. Questo problema è risolvibile in due modi: 1. dimostrando positivamente che non si possono sviluppare delle singolarità; 2. trovando una situazione che con determinate condizioni produce questa singolarità. Degli agenti AI utilizzati metà sono stati messi a risolvere il problema nel primo modo, metà nel secondo. Sono stati proprio questi ultimi a riuscire.
Dopo queste minime coordinate per intendere al meglio lo spessore del problema, possiamo discutere di ciò che è successo.
La faccenda è tutto fuorché priva di zone d’ombra. In primis, soprattutto per gli appassionati, nonostante OpenAI abbia fornito le dimostrazioni a queste equazioni, bisognerà aspettare almeno due anni affinché il Clay Mathematics Institute approvi la dimostrazione.
In secundis, in contemporanea alla dichiarazione di OpenAI, lo scienziato Tristan Buckmaster ha contestato l’azienda big tech sostenendo che l’azienda ha sostanzialmente rubato le idee a lui e ad un altro scienziato: Levent Alpöge.
Buckmaster sostiene che recentemente lui e Alpöge avevano reso pubblico tre risultati che riguardavano le equazioni di Navier-Stokes, basandosi su un programma di ricerca redatto da Diego Còrdoba e Luis Martìnez-Zoroa. Lo stesso programma da cui OpenAI sarebbe partito. Buckmaster e Alpöge non nascondono l’utilizzo estensivo di Large Language Model per farsi aiutare nella ricerca, tuttavia sostenendo che le dimostrazioni fornite dalle IA erano “orrende” e più vicine al genere del “AI slop”.
La controversia inizia il 3 settembre con Buckmaster che scrive ad un matematico di OpenAI poiché girava voce che dentro Anthropic – azienda programmatrice di Claude e competitor diretto di OpenAI – si fosse risolto uno dei problemi del millennio e che informazioni sul progresso dei due matematici fossero passate ad OpenAI. Senza entrare troppo nei dettagli tecnici, un problema di dimostrazione matematica può essere “attaccato” in modi differenti e vedere infine se porta ad un risultato e quanto è elegante. Il modo in cui Buckmaster e Alpöge hanno iniziato a lavorare al problema era un modo che stavano sperimentando solo loro due. Tuttavia, un altro scambio tra Alpöge e OpenAI ha messo in luce il fatto che la scoperta interna dell’azienda big tech ha seguito lo stesso “fronte d’attacco” fornendo al LLM soltanto un prompt che illustrava il problema. I due matematici vengono a sapere che è stato generato pochi giorni prima, ovvero quando è circolata l’informazione che ci fossero grandi progressi sulle equazioni di Navier-Stokes. OpenAI, in seguito, non è stata chiara con Buckmaster se e quanto il loro modello è stato addestrato con i lavori che i due matematici caricavano su Codex.
Buckmaster è stato, infine, messo davanti a due scelte da OpenAI, ormai praticamente allo scoperto di aver rubato le idee ai due matematici senza riconoscimento di sorta. Tutte e due le scelte mettevano davanti l’esclusione di Alpöge dagli autori poiché impiegato da Anthropic. Entrambe le scelte sono state rifiutate.
Questo è forse il primo caso – almeno di questa portata – di evidente furto di sapere da parte delle aziende big tech. Non solo mero furto di sapere, ma proprio della capacità attiva del ricercatore, della sua pratica attiva di fare ricerca e di condurla; in altre parole, non solo furto dell’informazione ma furto di produrla. In realtà non è in sé una novità: le aziende IA già distruggono quantità di libri antichi per assorbirne il sapere e si addestrano sulla quantità enorme di dati che ogni utente lascia in rete. Ma per la prima volta un’azienda rivendica che dietro una grande produzione di sapere – come la risoluzione di Navier-Stokes – ci sia poco o niente lavoro umano.
Una delle implicazioni è anche i livelli di potenza che le IA hanno raggiunto. Le equazioni di Navier-Stokes, come detto già prima, sono state formulate nel 1821. Da allora, ogni giorno, almeno un matematico ci ha lavorato sopra e a migliaia sono stati ispirati per iniziare a studiare in questo campo. Che un’IA l’abbia risolta in 88 ore è un dato non scontato, tuttavia senza scadere in tecno-fanatismi , la storia di Buckmaster e OpenAI ha fatto emergere il ruolo dell’intelligenza collettiva anche di fronte ad un lavoro che appare quasi totalmente macchinico. Che le IA da sole possano risolvere davvero un problema matematico da sole, invece, ci fa scadere in un tecno-pessimismo anche questo da evitare. Dunque ci discostiamo dal matematico cinese Deng Yu che, scherzosamente, ha recentemente affermato che se un’IA dovesse risolvere in autonomia un problema allora è il tempo per i matematici di darsi alla scrittura di romanzi. Aggiungiamo, questo tipo di sviluppo scientifico riproduce un idea di efficientismo per cui l’unica cosa che conta è arrivare al risultato prima possibile, ma non tiene conto del fatto che proprio una ricerca fatta di tentativi, errori, strade sbagliate è quella che ha portato come effetti collaterali in realtà proprio delle scoperte enormi. Proprio nei tentativi infruttuosi per risolvere l’ultimo teorema di Fermat è stato dato luogo alla teoria algebrica dei numeri e molti altri esempi.
Con i modelli di OpenAI disponibili sul mercato fino a Chat GPT-6 Astra è stato riscontrato moltissime volte come nelle dimostrazioni matematiche spesso essi cadano in argomentazioni “circolari”, assumendo implicitamente ciò che deve essere dimostrato, e questo tipo di argomentazioni non viene considerato un errore nella dimostrazione step by step.
Quello che stupisce è questo improvviso interesse in un campo notoriamente poco finanziato perché non direttamente profittevole, ossia quello della matematica pura. Infatti la risoluzione di questo problema non ha dei risvolti pratici effettivi, se non in parte per quanto riguarda casistiche estremamente esotiche come buchi neri ecc. Probabilmente la risoluzione di un problema di questo tipo risulta fondamentale nel quadro della propaganda che proprio in questi giorni mette in primo piano la pericolosità catastrofica dell’AI e l’ineffabilità del suo dominio sugli esseri umani, propaganda che ha chiari scopi di lucro. La matematica pura di per sé non è un campo del sapere altamente redditizio, come lo può essere il suo riflesso ossia la matematica applicata. L’interesse che le big tech AI hanno dentro questo campo è ignoto e forse ha più a che vedere con la “prova muscolare” della propria capacità di elaborazione dei propri modelli, che del rientro economico e basta.
In un’ottica macroscopica, andando oltre la faccenda appena raccontata, la specificità di questa fase della produzione capitalistica è eminentemente quella del furto della capacità umana per fini avversi alle classi subalterne. Come indicato da un articolo di Emiliana Armano, l’era dell’IA pone un salto qualitativo rispetto alla sussunzione della capacità umana e dell’intelligenza sociale per le sue capacità di calcolo. Questa storia inizia ad aiutarci a rispondere alla domanda di chi domina e gestisce questi processi sussuntivi e quanto tra questi che presidiano possano nascere cortocircuiti dettati dalla competitività capitalistica. In alcuni punti Buckmaster non si tira indietro affermando che se davvero OpenAI ha risolto le equazioni di Navier-Stokes questo è un passo in avanti per tutti e che tutta questa storia è paragonabile allo scontro scacchistico tra Kasparov e Deep Blue. L’intuizione è parzialmente corretta: il risultato delle equazioni non è allora un risultato nato dalla sola ricerca indipendente, ma è immediatamente proprietà di una azienda; in questo senso la sussunzione ha a che fare non solo con il processo di formulare la ricerca, ma anche con il risultato. Ciò che ci interessa di più, tuttavia, è ricercare e mettere a valore quelle sacche non effettivamente sussunte per rompere le finalità capitalistiche e deviare verso fini nostri.
Ti è piaciuto questo articolo? Infoaut è un network indipendente che si basa sul lavoro volontario e militante di molte persone. Puoi darci una mano diffondendo i nostri articoli, approfondimenti e reportage ad un pubblico il più vasto possibile e supportarci iscrivendoti al nostro canale telegram, o seguendo le nostre pagine social di facebook, instagram e youtube.